 PQStat
Porównywanie modeli regresji wielorakiej
Kiedy stosować:
Liniowa regresja wieloraka daje możliwość jednoczesnej analizy wielu zmiennych niezależnych. Pojawia się więc problem wyboru optymalnego modelu. W natłoku informacji, jakie niesie zbyt duży model, istnieje możliwość zagubienia ważnych informacji. Zbyt mały model może natomiast pominąć te cechy, które w wiarygodny sposób mogłyby opisać badane zjawisko – nie liczba zmiennych w modelu, ale ich jakość decyduje o jakości modelu. W wyborze zmiennych niezależnych niezbędna jest wiedza i doświadczenie związane z badanym zjawiskiem. Należy pamiętać, by w modelu znajdowały się zmienne silnie skorelowane ze zmienną zależną i słabo skorelowane między sobą.
Definicje miar
Nie istnieje jedna prosta reguła statystyczna, która decydowałaby o liczbie zmiennych niezbędnych w modelu. Najczęściej w porównaniu posługujemy się miarami dopasowania modelu, takimi jak: \(R_{adj}^2\) – poprawiona wartość współczynnika determinacji wielorakiej (im wyższa wartość, tym lepiej dopasowany model), \(SE_e\) – błąd standardowy estymacji (im niższa wartość, tym lepiej dopasowany model), lub kryteria informacyjne AIC, AICc, BIC (im niższa wartość, tym lepszy model). W tym celu można również wykorzystać test F oparty o współczynnik determinacji wielorakiej \(R^2\), służący do weryfikacji hipotezy, że dopasowanie obu porównywanych modeli jest tak samo dobre.
Jeśli porównywane modele nie różnią się istotnie, powinniśmy wybrać ten z mniejszą liczbą zmiennych – brak różnicy oznacza bowiem, że zmienne, które są w modelu pełnym, a nie ma ich w modelu zredukowanym, nie wnoszą istotnej informacji. Jeśli natomiast różnica w jakości dopasowania modeli jest istotna statystycznie, oznacza to, że jeden z nich (ten z większą liczbą zmiennych, o większym \(R^2\) lub mniejszej wartości kryterium informacyjnego) jest istotnie lepszy niż drugi.
Ręczne porównywanie modeli polega na zbudowaniu 2 modeli:
- pełnego – modelu z większą liczbą zmiennych,
- zredukowanego – modelu z mniejszą liczbą zmiennych; model taki powstaje z modelu pełnego po usunięciu zmiennych, które z punktu widzenia badanego zjawiska są zbędne.
Wybór zmiennych niezależnych w porównywanych modelach, a następnie wybór lepszego modelu na podstawie uzyskanych wyników porównania, należy do badacza.
Automatyczny dobór modelu – program sam buduje kolejne modele i wskazuje najlepszy według wybranego kryterium.
Składniki modelu. Jednostką, którą metody automatyczne dodają do modelu lub z niego usuwają, jest składnik: pojedyncza zmienna, cała zmienna fikcyjna (wszystkie jej kolumny 0–1 naraz) albo interakcja. Obowiązuje zasada hierarchii: interakcja może znaleźć się w modelu tylko wtedy, gdy są w nim jej efekty główne, i tylko ona może zostać usunięta przed nimi.
Kryterium doboru wybieramy w oknie analizy:
- AIC, AICc lub BIC – kryteria informacyjne; lepszy jest model o mniejszej wartości kryterium. Ruch (dodanie lub usunięcie składnika) jest przyjmowany tylko wtedy, gdy obniża kryterium;
- \(p\) testu zagnieżdżonego – test F porównujący model przed zmianą i po zmianie, z zadanym progiem \(p\). Składnik jest usuwany, gdy \(p\) jest większe od progu, a dodawany, gdy \(p\) jest mniejsze od progu. Ta sama wartość \(p\) jest pokazywana w raporcie jako porównanie sąsiednich modeli;
- błąd walidacji – błąd predykcji (RMSE) wyznaczony na obserwacjach, które nie brały udziału w dopasowaniu modelu (opis poniżej: Ocena modeli poza zbiorem uczącym). Ruch jest przyjmowany tylko wtedy, gdy zmniejsza ten błąd. Kryterium wymaga włączonej opcji Walidacja – wybranie go przy wyłączonej walidacji włącza walidację krzyżową.
Metody doboru:
- eliminacja wstecz – start od modelu ze wszystkimi zmiennymi; w każdym kroku usuwany jest ten składnik, którego usunięcie najbardziej obniża kryterium; koniec, gdy żadne usunięcie już go nie obniża;
- selekcja w przód – start od modelu zerowego (tylko wyraz wolny); w każdym kroku dodawany jest składnik najbardziej obniżający kryterium; koniec, gdy żadne dodanie już go nie obniża;
- krokowa dwukierunkowa – start od modelu zerowego; w każdym kroku rozważane są zarówno dodania, jak i usunięcia składników i wybierany jest najlepszy ruch; koniec, gdy żaden ruch nie poprawia kryterium;
- wszystkie podzbiory – dopasowywane są wszystkie modele zgodne z zasadą hierarchii (maksymalnie 15 składników), a w raporcie prezentowany jest najlepszy model każdej wielkości; metoda korzysta z kryteriów informacyjnych albo z błędu walidacji (kryterium \(p\) nie jest w niej dostępne).
Wszystkie modele są liczone na tym samym zbiorze obserwacji – wiersze z brakami w którejkolwiek ze zmiennych kandydujących są odrzucane raz, przed analizą. Dzięki temu kryteria informacyjne i testy porównawcze są między modelami porównywalne.
Raport zawiera: metodę i kryterium doboru, liczbę składników i dopasowanych modeli, kryteria informacyjne modelu zerowego, kolejne modele ścieżki doboru (każdy z miarami dopasowania \(R_{adj}^2\), \(SE_e\), AIC, AICc, BIC oraz tabelą współczynników) i porównanie każdej sąsiedniej pary modeli testem F (statystyka, stopnie swobody, wartość \(p\)). Najlepszy model według wybranego kryterium jest oznaczony w raporcie. Jeśli żaden składnik nie poprawia modelu zerowego, raport informuje, że najlepszy jest model zerowy. Przy metodzie wszystkich podzbiorów sąsiednie modele mogą nie być zagnieżdżone – wówczas test F nie jest wykonywany.
Ocena modeli poza zbiorem uczącym
Miary dopasowania (\(R_{adj}^2\), \(SE_e\)), kryteria informacyjne i testy są wyznaczane na tych samych obserwacjach, na których oszacowano współczynniki modelu. Taka ocena jest zbyt optymistyczna: model dopasowuje się także do przypadkowych cech próby, więc nowe obserwacje przewiduje zwykle gorzej, niż wynikałoby to z jego dopasowania, a im więcej zmiennych w modelu, tym większa jest ta różnica. Dobór oparty wyłącznie na zbiorze uczącym nie zawsze wskazuje więc model, który najlepiej sprawdzi się na nowych danych. Dlatego w oknie analizy można włączyć ocenę modeli na obserwacjach, które nie brały udziału w ich dopasowaniu (opcja Walidacja):
- walidacja krzyżowa \(k\)-krotna – obserwacje są losowo dzielone na \(k\) części o zbliżonej liczności. Każdy model jest dopasowywany \(k\) razy, za każdym razem z pominięciem jednej części, i służy do przewidzenia wartości zmiennej zależnej w pominiętej części. Każda obserwacja zostaje więc przewidziana dokładnie raz – przez model, który jej „nie widział”. Modele prezentowane w raporcie (współczynniki, miary dopasowania, kryteria informacyjne, testy) są dopasowane na wszystkich obserwacjach, a miary walidacji są ich uzupełnieniem. Najczęściej stosuje się \(k=5\) lub \(k=10\);
- losowy zbiór testowy – zadany procent obserwacji jest losowo odkładany jako zbiór testowy. Wszystkie modele są dopasowywane wyłącznie na pozostałej części (zbiorze uczącym) – to jej dotyczą współczynniki, miary dopasowania, kryteria informacyjne i testy w raporcie – a oceniane na zbiorze testowym. Sposób ten jest prostszy i szybszy, ale wymaga większej próby: modele powstają na mniejszej liczbie obserwacji, a ocena opiera się na jednym, często niewielkim zbiorze.
Podział jest losowy, ale w pełni wyznaczony przez Ziarno: to samo ziarno daje zawsze ten sam podział, więc analizę można powtórzyć, a wszystkie modele jednej analizy są oceniane na identycznym podziale. Zmiana ziarna daje inny podział i nieco inne wartości miar – jeśli po zmianie ziarna zmienia się kolejność modeli, to różnice między nimi są mniejsze niż losowa zmienność podziału i nie należy przywiązywać do nich wagi.
Dla każdego modelu raport podaje wówczas trzy dodatkowe miary:
- RMSE – pierwiastek ze średniego kwadratu błędu predykcji, wyrażony w jednostkach zmiennej zależnej; odpowiednik \(SE_e\) wyznaczony poza zbiorem uczącym (im mniejsza wartość, tym lepszy model);
- MAE – średni błąd bezwzględny predykcji; mniej wrażliwy na pojedyncze duże błędy niż RMSE;
- \(R^2\) predykcji – część zmienności zmiennej zależnej wyjaśniona przez przewidywania poza zbiorem uczącym; odpowiednik \(R^2\), zwykle od niego mniejszy. Wartość ujemna oznacza, że model przewiduje nowe obserwacje gorzej niż sama średnia.
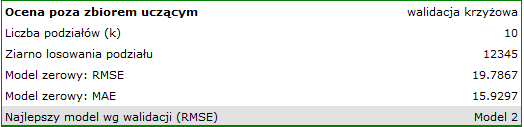
Punktem odniesienia jest model zerowy, który każdej obserwacji przypisuje średnią zmiennej zależnej z części uczącej – jego RMSE i MAE raport podaje w bloku doboru modelu. Tam też wskazany jest najlepszy model wg walidacji, czyli model o najmniejszym RMSE poza zbiorem uczącym. Jest on wskazywany niezależnie od wybranego kryterium doboru, dzięki czemu można sprawdzić, czy model wybrany np. przez AIC jest również tym, który najlepiej przewiduje nowe obserwacje. Ocena poza zbiorem uczącym działa także przy ręcznym porównywaniu modeli – raport podaje wtedy miary obu modeli.
Jeśli jako Kryterium wybrano błąd walidacji, na błędzie poza zbiorem uczącym opierają się również kolejne kroki doboru i oznaczenie najlepszego modelu. Każdy rozważany model jest wtedy dopasowywany dodatkowo \(k\) razy, więc obliczenia trwają dłużej.
Jak ustawić analizę
Statystyka \(\to\) Modele wielowymiarowe \(\to\) Regresja wieloraka – porównywanie modeli.

W oknie wskazujemy zmienną zależną \(Y\) oraz zmienne niezależne modelu pełnego i zredukowanego (w doborze automatycznym – zmienne kandydujące). Opcje doboru modelu:
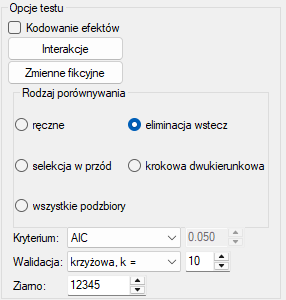
- Rodzaj porównywania – ręczne albo jedna z metod doboru automatycznego: eliminacja wstecz, selekcja w przód, krokowa dwukierunkowa, wszystkie podzbiory,
- Kryterium – AIC, AICc, BIC, p (test LR / F) z progiem podawanym w polu obok albo błąd walidacji; w trybie ręcznym kryterium nie jest używane,
- Walidacja – brak (ocena tylko na zbiorze uczącym), krzyżowa, k = z liczbą podziałów w polu obok (od 2 do 100, domyślnie 10) albo zbiór testowy, % = z udziałem zbioru testowego w procentach obserwacji (od 5 do 90, domyślnie 30),
- Ziarno – ziarno losowania podziału danych (domyślnie 12345); to samo ziarno oznacza ten sam podział.
Wykonanie i interpretacja
Kontynuacja przykładu 1 (plik wydawca.pqs): do przewidywania zysku brutto ze sprzedaży książek wydawca planuje brać pod uwagę takie zmienne jak: koszty produkcji, koszty reklamy, koszty promocji bezpośredniej, suma udzielonych rabatów, popularność autora. Nie wszystkie te zmienne muszą jednak wpływać znacząco na zysk. Spróbujemy wybrać taki model regresji liniowej, który będzie zawierał optymalną (ze statystycznego punktu widzenia) liczbę zmiennych. Do tej analizy użyjemy danych zbioru uczącego.
Ręczne porównywanie modeli
Na podstawie zbudowanego wcześniej modelu pełnego możemy podejrzewać, że zmienne: koszty promocji bezpośredniej i suma udzielonych rabatów mają niewielki wpływ na budowany model. Sprawdzimy, czy ze statystycznego punktu widzenia model pełny jest lepszy niż model po usunięciu tych dwóch zmiennych.


Dodatkowo, model zredukowany jest nieco lepiej dopasowany niż model pełny (dla modelu zredukowanego \(R_{adj}^2=0.8296\), dla modelu pełnego \(R_{adj}^2=0.8291\)) oraz ma mniejsze, czyli korzystniejsze, wartości kryteriów informacyjnych AIC, AICc i BIC.
Automatyczny dobór modelu
Dobór automatyczny (eliminacja wstecz, kryterium AIC) daje bardzo podobne wyniki. Najlepszym modelem jest model o największym współczynniku \(R^2_{adj}\), najmniejszych kryteriach informacyjnych i najmniejszym błędzie standardowym estymacji \(SE_e\). Sugerowanym najlepszym modelem jest tu model zawierający tylko 3 zmienne niezależne: koszty produkcji, koszty reklamy, popularność autora.
Ocena poza zbiorem uczącym
Dotychczasowe porównania opierały się na tych samych 40 książkach, na których dopasowano modele. Sprawdzimy, czy wybór się potwierdzi, gdy modele będą oceniane na obserwacjach, które nie brały udziału w ich dopasowaniu. W oknie analizy zostawiamy eliminację wstecz i kryterium AIC, a w polu Walidacja wybieramy krzyżowa, k = i wpisujemy 10 podziałów (ziarno 12345).
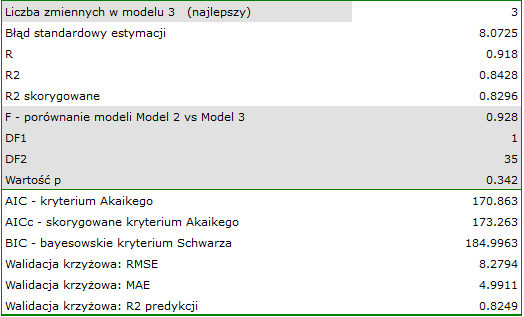
W bloku doboru modelu raport podaje sposób oceny, błąd modelu zerowego i model najlepszy według walidacji, a przy każdym modelu – trzy wiersze miar walidacji krzyżowej.
| zbiór uczący | walidacja krzyżowa (\(k=10\)) | ||||||
| model | zmienne | \(SE_e\) | \(R^2_{adj}\) | AIC | RMSE | MAE | \(R^2\) predykcji |
| zerowy | 0 | 19.7867 | 15.9297 | ||||
| Model 1 | 5 | 8.0865 | 0.8291 | 172.7149 | 8.3425 | 5.2976 | 0.8222 |
| Model 2 | 4 | 8.0806 | 0.8293 | 171.8163 | 8.2309 | 5.1237 | 0.8270 |
| Model 3 | 3 | 8.0725 | 0.8296 | 170.8630 | 8.2794 | 4.9911 | 0.8249 |
Model 1 to model pełny, Model 2 powstał z niego po usunięciu kosztów promocji bezpośredniej, a Model 3 – po usunięciu dodatkowo sumy rabatów. Wszystkie trzy przewidują zysk wielokrotnie lepiej niż model zerowy (RMSE około 8.3 wobec 19.8), a \(R^2\) predykcji (0.82–0.83) jest tylko nieznacznie niższe od \(R^2_{adj}\) – modele nie są więc przeuczone. Błąd poza zbiorem uczącym jest przy tym nieco większy niż błąd standardowy estymacji (dla Modelu 3: 8.28 wobec 8.07), czego należało się spodziewać.
Najmniejszy błąd walidacji ma Model 2 (RMSE \(=8.2309\)), a wskazany przez AIC Model 3 jest tuż za nim (RMSE \(=8.2794\)) i ma najmniejszy średni błąd bezwzględny (MAE \(=4.9911\)). Różnice między tymi modelami są znikome w porównaniu z samą wielkością błędu, natomiast model pełny – choć na zbiorze uczącym jest najlepiej dopasowany (ma największe \(R^2\)) – nowe obserwacje przewiduje najsłabiej z całej trójki (RMSE \(=8.3425\)). Usunięcie kosztów promocji bezpośredniej i sumy rabatów nie pogarsza więc przewidywań, a walidacja potwierdza wybór modelu z 3 zmiennymi.
Na podstawie powyższych analiz, ze statystycznego punktu widzenia, optymalnym modelem jest model zawierający 3 najważniejsze zmienne niezależne: koszty produkcji, koszty reklamy, popularność autora. Jednak ostateczna decyzja, który model wybrać, należy do osoby posiadającej specjalistyczną wiedzę z zakresu badania – w tym przypadku wydawcy. Należy pamiętać, że wybrany model powinien zostać ponownie zbudowany, a jego założenia zweryfikowane w oknie Regresja wieloraka.
Hipotezy:
\(\begin{array}{cc} \mathcal{H}_0: & R_{FM}^2=R_{RM}^2,\\ \mathcal{H}_1: & R_{FM}^2\ne R_{RM}^2, \end{array}\)
gdzie \(R_{FM}^2, R_{RM}^2\) – współczynniki determinacji wielorakiej w porównywanych modelach (pełnym i zredukowanym).
Wzory: statystyka testowa ma postać:
Statystyka ta podlega rozkładowi F Snedecora z \(df_1=k_{FM}-k_{RM}\) i \(df_2=n-k_{FM}-1\) stopniami swobody.
Wyznaczoną na podstawie statystyki testowej wartość \(p\) porównujemy z poziomem istotności \(\alpha\): gdy \(p \le \alpha\), odrzucamy \(\mathcal{H}_0\) na rzecz \(\mathcal{H}_1\); gdy \(p > \alpha\), nie ma podstaw, aby odrzucić \(\mathcal{H}_0\).
Ocena poza zbiorem uczącym
Niech \(\hat{y}_{(-i)}\) oznacza wartość przewidzianą dla obserwacji \(i\) przez model dopasowany bez tej części danych, do której należy obserwacja \(i\) (w walidacji krzyżowej – bez jej podziału, przy zbiorze testowym – na zbiorze uczącym), a \(\overline{y}_{(-i)}\) – średnią zmiennej zależnej w tej samej części uczącej. Miary wyznaczane są łącznie dla wszystkich \(n_v\) ocenianych obserwacji (w walidacji krzyżowej – wszystkich obserwacji, przy zbiorze testowym – obserwacji zbioru testowego):
Mianownik \(R^2_{pred}\) to suma kwadratów błędów modelu zerowego, dlatego \(R^2_{pred}\) pokazuje, o jaką część model zmniejsza błąd predykcji w stosunku do modelu zerowego.
Podział: obserwacje są losowo tasowane (generator liczb pseudolosowych o stanie początkowym równym ziarnu), a następnie – w walidacji krzyżowej – przydzielane kolejno do \(k\) części, których liczności różnią się najwyżej o 1; przy zbiorze testowym do zbioru testowego trafia zadany procent obserwacji (po zaokrągleniu do liczby całkowitej). Gdy \(k\) jest większe od liczby obserwacji, przyjmowane jest \(k\) równe liczbie obserwacji. Jeśli obserwacji jest zbyt mało, by wydzielić część danych do walidacji, program informuje o tym komunikatem.