 PQStat
Test Z dla dwóch niezależnych proporcji
Kiedy stosować ten test:
Test \(Z\) dla dwóch niezależnych proporcji stosujemy w podobnych sytuacjach jak test \(\chi^2\) (\(2\times2\)): gdy mamy 2 niezależne próby, w których badana cecha przyjmuje jeden z dwóch możliwych wyników, a chcemy sprawdzić, czy odsetek (proporcja) wyróżnionego wyniku jest taki sam w obu populacjach, z których pochodzą próby.
Warunki stosowania
- pomiar na skali nominalnej – ewentualne uporządkowanie kategorii nie jest brane pod uwagę,
- model niezależny,
- duża liczność.
Jak ustawić analizę
Statystyka \(\to\) Testy nieparametryczne \(\to\) Z dla dwóch niezależnych proporcji.
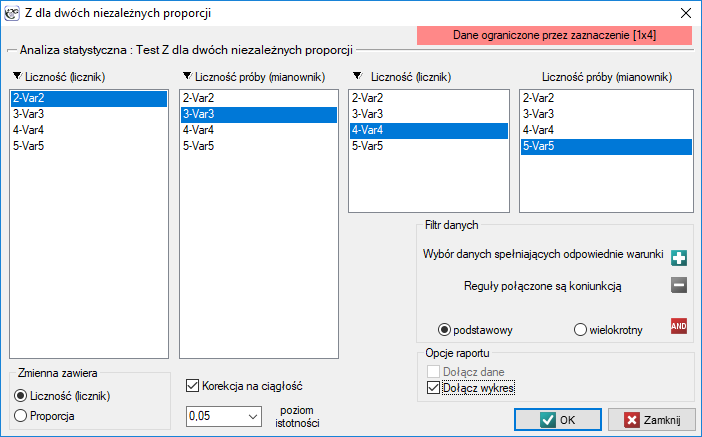
Wykonanie i interpretacja
Przykład 1. Przykład (1) c.d. (plik płeć-egzamin.pqs)
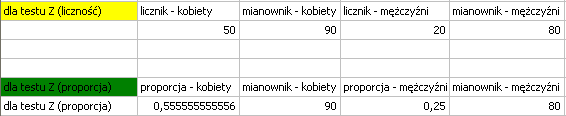
Wiemy, że \(\frac{50}{90}=55.56\%\) kobiet w próbie zdało egzamin pozytywnie i \(\frac{20}{80}=25.00\%\) mężczyzn w próbie zdało egzamin pozytywnie. Chcemy sprawdzić, czy w badanej populacji proporcja zdawalności różni się między płciami.
Dane możemy zapisać na dwa sposoby – jako licznik i mianownik dla każdej próby, lub jako proporcja i mianownik dla każdej próby:
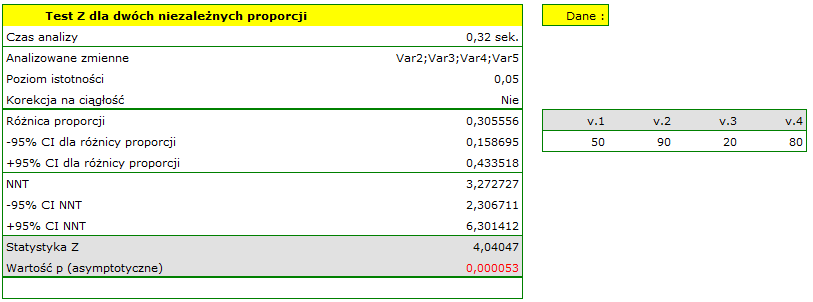
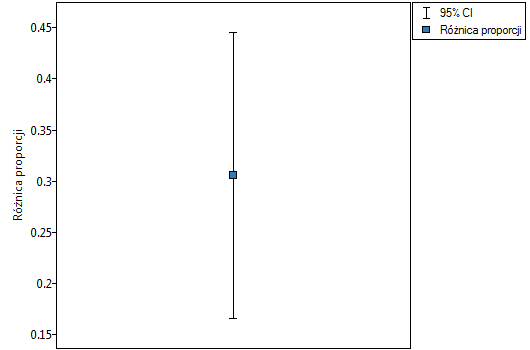
Różnica proporcji wyróżnionych w próbie to 30.56%, a jej 95% przedział ufności \((15.90\%, 43.35\%)\) nie zawiera 0. Do tego samego wniosku prowadzi test \(Z\) z poprawką na ciągłość (\(p=0.0001\)) – podobnie jak wcześniej wykonane testy: dokładny Fishera, mid-p, chi-kwadrat i chi-kwadrat z poprawką Yatesa. Istotnie częściej ten egzamin zdają kobiety (55.56% z próby) niż mężczyźni (25.00% z próby).
Przykład 2. Załóżmy, że choroba ma śmiertelność 100% bez leczenia, a terapia zmniejsza śmiertelność do 50% – jest to wynik 20-letnich badań. Chcemy wiedzieć, ilu osób trzeba leczyć, aby zapobiec w ciągu 20 lat 1 śmierci. W tym celu pobrano dwie 100-osobowe próby z populacji osób chorych: w próbie nieleczonych wszyscy 100 pacjentów umiera, w próbie leczonych przeżywa 50 ze 100 pacjentów.
| Chorzy – nie leczeni | Chorzy – leczeni | ||
| liczność licznik | liczność próby (mianownik) | liczność licznik | liczność próby (mianownik) |
| 100 | 100 | 50 | 100 |
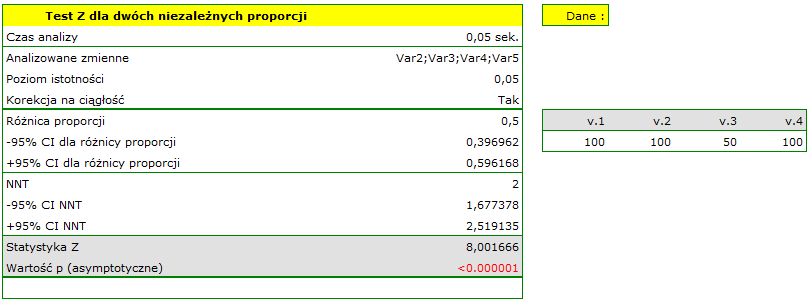
Wyliczony 95% przedział ufności dla NNT należy zaokrąglić do wartości całkowitych, co daje NNT od 2 do 3 chorych.
Przykład 3. Wartość pewnej różnicy proporcji w badaniu porównującym skuteczność leku 1 vs lek 2 wynosiła (95%CI) \(=-0.08\) (\(-0.27\) do \(0.11\)). Ta ujemna różnica proporcji sugeruje, że lek 1 był mniej skuteczny niż lek 2, a jego zastosowanie naraziło chorych na ryzyko.
Definicje miar
NNT (ang. number needed to treat) – wskaźnik stosowany w medycynie, oznacza liczbę pacjentów, których trzeba poddać leczeniu przez określony czas, aby wyleczyć jedną osobę, która w innych okolicznościach nie wyzdrowiałaby.
NNH (ang. number needed to harm) – wskaźnik stosowany w medycynie, oznacza liczbę pacjentów, których narażenie na ryzyko przez określony czas powoduje uszczerbek na zdrowiu u jednej osoby, która w innych okolicznościach nie doznałaby uszczerbku.
Definicja: Niech \(p_1=\frac{m_1}{n_1}\) i \(p_2=\frac{m_2}{n_2}\) oznaczają wyróżnione proporcje w próbach o licznościach \(n_1\), \(n_2\), gdzie \(m_1\), \(m_2\) – liczności wyniku wyróżnionego w pierwszej i drugiej próbie.
Hipotezy:
\( \begin{array}{cl} \mathcal{H}_0: & P_1=P_2,\\ \mathcal{H}_1: & P_1\neq P_2, \end{array} \)
gdzie \(P_1\), \(P_2\) – wyróżnione proporcje w pierwszej i drugiej populacji.
Wzory: Statystyka testowa ma postać:
gdzie \(p=\frac{m_1+m_2}{n_1+n_2}\).
Zmodyfikowana o poprawkę na ciągłość statystyka testowa ma postać:
Statystyka bez korekcji na ciągłość, jak i z tą korekcją, ma asymptotycznie (dla dużych liczności) rozkład normalny.
Wzory – NNT/NNH: NNT wyliczane jest ze wzoru:
i jest cytowane wtedy, gdy różnica \(p_1-p_2\) jest dodatnia. NNH wyliczane jest w ten sam sposób co NNT, ale cytowane wtedy, gdy różnica \(p_1-p_2\) jest ujemna.
Interpretacja: Im węższy przedział ufności, tym bardziej precyzyjne oszacowanie. Jeśli przedział ufności dla różnicy proporcji zawiera 0 (a dla NNT/NNH – zawiera \(\infty\)), jest to wskazanie, by dany wynik traktować jako nieistotny statystycznie.
Metoda estymacji przedziału ufności – przedziały ufności dla różnicy dwóch niezależnych proporcji, od wersji PQStat 1.3.0, estymowane są metodą Newcomba-Wilsona (Bender 2001[18], Newcombe 1998[126], Wilson 1927[176]); wcześniej stosowano metodę Walda. Metoda Walda jest odpowiednia dla dużych prób i różnicy proporcji dalekiej od 0 lub 1 – dla małych prób i wartości bliskich tym skrajnym może prowadzić do wyników niewiarygodnych (Newcombe 1998[126], Miettinen 1985[123], Beal 1987[17], Wallenstein 1997[168]). Metoda Newcomba-Wilsona jest odpowiednia również dla skrajnych wartości proporcji.