 PQStat
ANOVA dla grup niezależnych z korektą \(F^*\) i \(F''\)
Kiedy stosować ten test:
Korekty \(F^*\) (Brown-Forsythe, 1974[33]) oraz \(F''\) (Welch, 1951[171]) to warianty ANOVA dla grup niezależnych stosowane wtedy, gdy wariancje badanej zmiennej w porównywanych populacjach różnią się istotnie. Cel testu jest taki sam jak dla wariantu podstawowego – różni się jedynie sposób wyliczenia statystyki testowej i stopni swobody (zob. Dla zainteresowanych).
Warunki stosowania
- pomiar na skali interwałowej,
- normalność rozkładu badanej zmiennej w każdej populacji,
- model niezależny,
- istotnie różne wariancje badanej zmiennej między populacjami (w przeciwnym razie stosuje się ANOVA dla grup niezależnych bez korekty).
Jak ustawić analizę
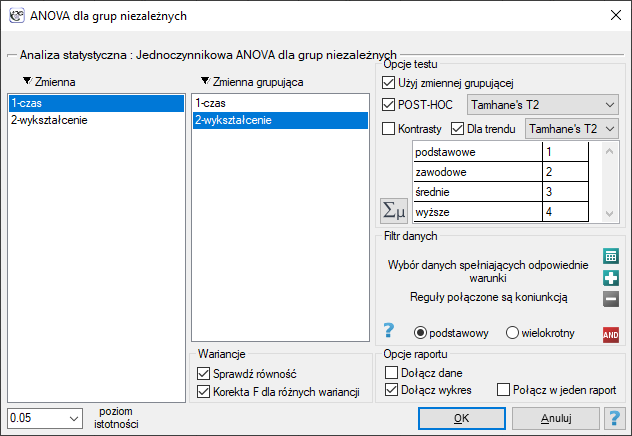
Statystyka \(\to\) Testy parametryczne \(\to\) ANOVA dla grup niezależnych (lub poprzez Kreator).
Wykonanie i interpretacja
Przykład 1. (plik bezrobocie.pqs)
Jest wiele czynników regulujących czas poszukiwania pracy w dobie kryzysu gospodarczego. Jednym z najważniejszych może być poziom wykształcenia. Przykładowe dane dotyczące wykształcenia oraz czasu (w miesiącach) pozostawania bezrobotnym zebrano w pliku. Chcemy sprawdzić, czy istnieją różnice w średnim czasie poszukiwania pracy dla poszczególnych kategorii wykształcenia.
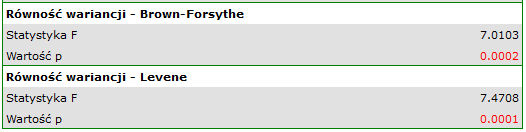
Ze względu na różnice dotyczące wariancji pomiędzy poszczególnymi populacjami (dla testu Levene'a wartość \(p=0.0001\), a dla testu Browna-Forsythe'a wartość \(p=0.0002\)):
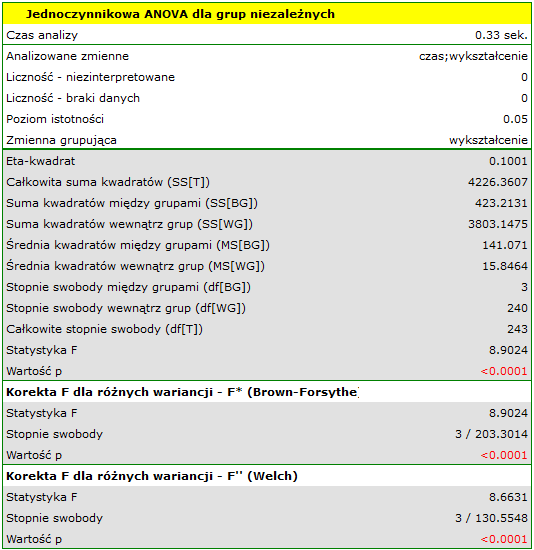
analizę przeprowadzamy przy włączonej korekcie różnych wariancji. Uzyskany wynik skorygowanej statystyki \(F\) jest przedstawiony poniżej.
Wykonując jeden z testów POST-HOC dedykowanych porównaniu grup o różnych wariancjach (zob. Dla zainteresowanych), dowiadujemy się, których kategorii wykształcenia dotyczą stwierdzone różnice:
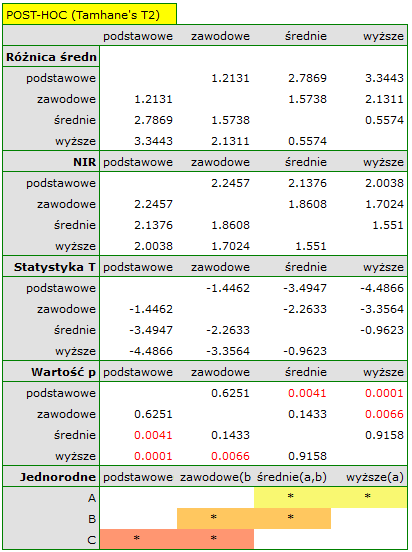
Najmniejsza istotna różnica (NIR) wyznaczona dla każdej pary porównań nie jest taka sama (mimo, że liczności grup są sobie równe), ponieważ nie są równe wariancje. Odnosząc wartość NIR do uzyskanych różnic wartości średnich, uzyskamy ten sam rezultat co, porównując wartość \(p\) z poziomem istotności \(\alpha=0.05\). Różnice dotyczą wykształcenia podstawowego i wyższego, wykształcenia podstawowego i średniego oraz wykształcenia zawodowego i wyższego. Powstałe grupy jednorodne zazębiają się. Generalnie jednak, spoglądając na wykres, możemy oczekiwać, że im bardziej wykształcona osoba, tym mniej czasu zajmuje jej poszukiwanie pracy.
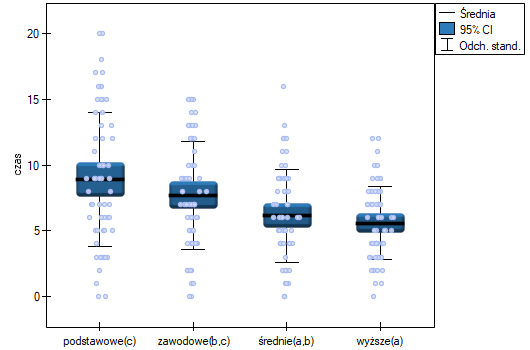
By móc sprawdzić tak postawioną hipotezę, podejmujemy analizę dla trendu. W tym celu wznawiamy analizę przyciskiem  i w oknie opcji testu wybieramy metodę Tamhane's T2 oraz opcję Dla trendu, wskazując kolejność kategorii wykształcenia kolejnymi liczbami naturalnymi.
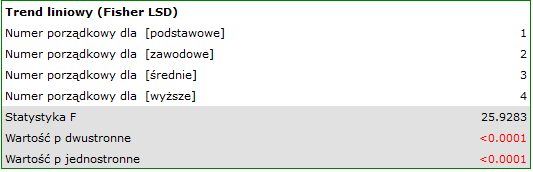
W zależności od tego, czy kierunek zależności pomiędzy wykształceniem a czasem poszukiwania pracy jest nam znany, wykorzystujemy jednostronną lub dwustronną wartość \(p\). Obie te wartości są mniejsze niż zadany poziom istotności – przewidywany przez nas trend został potwierdzony, czyli na poziomie istotności \(\alpha=0.05\) możemy powiedzieć, że ów trend rzeczywiście istnieje w populacji, z której pochodzi próba.
Hipotezy:
Wzory:
Statystyka testowa ma postać:
gdzie:
\(sd_j\) – odchylenie standardowe grupy \(j\),
\(w_j=\frac{n_j}{sd_j^2}\) – waga grupy \(j\),
\(\widetilde{x}\) – średnia ważona,
\(h_j=\frac{\left(1-\frac{w_j}{\sum_{j=1}^kw_j}\right)^2}{n_j-1}\).
Statystyka ta podlega rozkładowi F Snedecora z \(k-1\) i skorygowanymi \(df_{WG_k}\) stopniami swobody.
Wyznaczoną na podstawie statystyki testowej wartość \(p\) porównujemy z poziomem istotności \(\alpha\): gdy \(p \le \alpha\), odrzucamy \(\mathcal{H}_0\) na rzecz \(\mathcal{H}_1\); gdy \(p > \alpha\), nie ma podstaw, aby odrzucić \(\mathcal{H}_0\).
Testy POST-HOC
Wprowadzenie do kontrastów i testów POST-HOC znajduje się w rozdziale Kontrasty i testy POST-HOC dotyczącym jednoczynnikowej analizy wariancji. Poniższe metody, w odróżnieniu od testów LSD Fishera, Scheffego i Tukeya, stosuje się, gdy wariancje badanej zmiennej różnią się istotnie.
Test T2 Tamhane
Dla porównań prostych i złożonych zarówno równolicznych jak i różnolicznych grup (Tamhane A. C., 1977[159]).
- \(\mathfrak{(i)}\)
Wartość najmniejszej istotnej różnicy wyliczana jest z wzoru:
\[ NIR=\sqrt{F_{\alpha_{Sidak},1,df_v}}\cdot \sqrt{\left(\sum_{j=1}^k \frac{c_j^2sd_j^2}{n_j}\right)}, \]gdzie \(F_{\alpha_{Sidak},1,df_v}\) to wartość krytyczna (statystyka) rozkładu F Snedecora dla zmodyfikowanego poziomu istotności \(\alpha_{Sidak}\) oraz dla stopni swobody 1 i \(df_{v}\) odpowiednio,
\(\alpha_{Sidak}=1-(1-\alpha)^{(1/k)}\),
\(df_v=\frac{\left(\sum_{j=1}^k\frac{c_j^2sd_j^2}{n_j}\right)^2}{\sum_{j=1}^k\frac{c_j^4sd_j^4}{n_j^2(n_j-1)}}\) - \(\mathfrak{(ii)}\)
Statystyka testowa ma postać:
\[ t=\frac{\left(\sum_{j=1}^k c_j\overline{x}_j\right)^2}{\sqrt{\left(\sum_{j=1}^k \frac{c_j^2sd_j^2}{n_j}\right)}}. \]Statystyka ta podlega rozkładowi \(t\)-Studenta z \(df_v\) stopniami swobody, a wartość \(p\) jest korygowana o liczbę możliwych porównań prostych.
Test BF (Brown-Forsythe)
Dla porównań prostych zarówno równolicznych jak i różnolicznych grup (Brown M. B. i Forsythe A. B., 1974[32]).
- \(\mathfrak{(i)}\)
Wartość najmniejszej istotnej różnicy wyliczana jest z wzoru:
\[ NIR=\sqrt{F_{\alpha,k-1,df_v}}\cdot \sqrt{(k-1)\left(\sum_{j=1}^k \frac{c_j^2sd_j^2}{n_j}\right)}, \]gdzie \(F_{\alpha,k-1,df_v}\) to wartość krytyczna (statystyka) rozkładu F Snedecora dla zadanego poziomu istotności \(\alpha\) oraz \(k-1\) i \(df_v\) stopni swobody.
- \(\mathfrak{(ii)}\)
Statystyka testowa ma postać:
\[ F=\frac{\left(\sum_{j=1}^k c_j\overline{x}_j\right)^2}{(k-1)\left(\sum_{j=1}^k \frac{c_j^2sd_j^2}{n_j}\right)}. \]Statystyka ta podlega rozkładowi F Snedecora z \(k-1\) i \(df_v\) stopniami swobody.
Test GH (Games-Howell)
Dla porównań prostych zarówno równolicznych jak i różnolicznych grup (Games P. A. i Howell J. F., 1976[68]).
- \(\mathfrak{(i)}\)
Wartość najmniejszej istotnej różnicy wyliczana jest z wzoru:
\[ NIR=\frac{q_{\alpha,k,df_v} \cdot \sqrt{\left(\sum_{j=1}^k \frac{c_j^2sd_j^2}{n_j}\right)}}{\sqrt{2}}, \]gdzie \(q_{\alpha,k,df_v}\) to wartość krytyczna (statystyka) rozkładu studentyzowanego rozstępu dla zadanego poziomu istotności \(\alpha\) oraz \(k\) i \(df_v\) stopni swobody.
- \(\mathfrak{(ii)}\)
Statystyka testowa ma postać:
\[ q=\sqrt{2}\frac{\sum_{j=1}^k c_j\overline{x}_j}{\sqrt{\left(\sum_{j=1}^k \frac{c_j^2sd_j^2}{n_j}\right)}}. \]Statystyka ta podlega rozkładowi studentyzowanego rozstępu z \(k\) i \(df_v\) stopniami swobody.
Test dla trendu
Test badający istnienie trendu może być wyliczany w takiej samej sytuacji jak ANOVA dla grup niezależnych z korektą \(F^*\) i \(F''\), gdyż bazuje na tych samych założeniach, inaczej jednak ujmuje hipotezę alternatywną – wskazując w niej na istnienie trendu wartości średnich dla kolejnych populacji. Analiza trendu w ułożeniu średnich oparta jest na kontrastach T2 Tamhane. Tabela przykładowych wartości kontrastów dla wybranych trendów znajduje się w opisie testu dla trendu dla ANOVA bez korekty dla różnych wariancji.
Trend liniowy analizujemy w oparciu o kontrast liniowy, przypisując grupom uporządkowanym w naturalny sposób odpowiednie wartości kontrastu i wyliczając statystykę T2 Tamhane. Przy znanym oczekiwanym kierunku trendu hipoteza alternatywna jest jednostronna i interpretacji podlega jednostronna wartość \(p\); interpretacja dwustronnej wartości \(p\) oznacza, że badacz nie zna (nie zakłada) kierunku ewentualnego trendu. Wyznaczoną wartość \(p\) porównujemy z \(\alpha\): gdy \(p \le \alpha\), odrzucamy \(\mathcal{H}_0\) na rzecz \(\mathcal{H}_1\); gdy \(p > \alpha\), nie ma podstaw, aby odrzucić \(\mathcal{H}_0\).