 PQStat
ZESTAWIENIA TESTÓW
Zamiast wykonywać kolejne testy pojedynczo, program pozwala uruchomić od razu zestaw kilku analiz naraz, dobranych do rodzaju porównywanych grup. Dane ilościowe zostaną przy okazji opisane średnimi, medianami itp., a dane jakościowe – licznościami i procentami.
Jak uruchomić zestawienie
Okno z ustawieniami opcji Zestawień testów wywołujemy poprzez menu Statystyka\(\to\)Zestawy\(\to\)Zestawienia testów, a następnie wybieramy odpowiednią grupę analiz.

Do wyboru mamy cztery grupy zestawień:
Porównanie dwóch grup zależnych:
- Test t-Studenta dla grup zależnych
- Test Wilcoxona dla grup zależnych
- Test Bowkera-McNemara
- Test normalności rozkładu Kołmogorov-Smirnov (lub inny zaproponowany przez użytkownika)
- i inne ...
Porównanie dwóch grup niezależnych:
- Test t-Studenta dla grup niezależnych
- Test U Manna-Whitneya
- Chi-kwadrat, Fisher, OR/RR
- Test normalności rozkładu Kołmogorov-Smirnov (lub inny zaproponowany przez użytkownika)
- i inne ...
Porównanie wielu grup niezależnych (zob. opis poniżej):
- ANOVA dla grup niezależnych i ANOVA z korektą Welcha
- ANOVA Kruskala-Wallisa
- Chi-kwadrat i test Fishera dla dużych tabel
- Test Levene'a równości wariancji, test normalności rozkładu (jak wyżej)
- testy post-hoc (Tukey HSD, Tamhane T2, Dunn, porównania par tabel) i grupy jednorodne
- i inne ...
Korelację:
- Zależność liniowa Pearsona
- Zależność monotoniczna Spearmana
- Chi-kwadrat, Fisher, wsp. korelacji
- Test normalności rozkładu Kołmogorov-Smirnov (lub inny zaproponowany przez użytkownika)
- i inne ...
Co zwraca program
Dla każdej analizowanej zmiennej, w zależności od tego czy jest ona ilościowa czy jakościowa, program może zwrócić w raporcie wyniki:
- wybranego testu – dobranego automatycznie wg reguły opisanej poniżej;
- wszystkich testów i towarzyszących im współczynników oraz miar, niezależnie od tego, czy spełnione są minimalne warunki ich stosowania.
Jak program dobiera test automatycznie
- Jeśli przed analizą użytkownik nie opisze poszczególnych zmiennych odpowiednimi skalami, dane ilościowe są traktowane jak skala interwałowa, a dane jakościowe – jak skala nominalna.
Badanie normalności rozkładu opiera się na wyniku testu normalności wybranego przez użytkownika podczas ustawiania statystyk opisowych.

- Jeśli użytkownik nie wskaże żadnego testu oceniającego normalność rozkładu w oknie tych statystyk, normalność zostanie sprawdzona testem Kołmogorova-Smirnowa.
Wykonanie i interpretacja
Przykład 1. (plik zestawienia.pqs)
Chcemy dokonać automatycznego porównania dwóch niezależnych grup: chorych przewlekle z chorującymi na ostrą postać choroby. Porównania dokonujemy w oparciu o dane opisane na skali interwałowej: Chol Całk., LDL, HDL, TG, w oparciu o cechę porządkową BMI, oraz o dane nominalne: Leczenie, Estradiol 1, Estradiol 2, Estradiol 3. W tym celu wybieramy menu Zestawy \(\to\) Zestawienia testów [dwie grupy niezależne] i zaznaczamy zmienną grupującą: Leczenie, następnie wybieramy dane interwałowe (w części dotyczącej zmiennych ilościowych) oraz dane nominalne i porządkowe (w części dotyczącej zmiennych jakościowych). Zaznaczamy opcję Wybrany test i wykonujemy analizę.


"Zmienne ilościowe:
Dla skali interwałowej z normalnością rozkładu wyznaczono test t-studenta (t-st) lub jego poprawkę Cochrana-Coxa (C-C), gdy wariancje grup różniły się. Dla skali interwałowej, gdy warunek normalności rozkładu nie był spełniony, podobnie jak dla skali porządkowej wyznaczono test Manna-Whitneya (M-W). Normalność rozkładu danych badano testem Shapiro-Wilka a równość wariancji testem Fishera-Snedecora (F-S). Jeśli nie oznaczono skali dla analizowanych zmiennych, przyjęto, że dane pochodzą ze skali interwałowej.
Zmienne jakościowe:
Dla skali nominalnej wyznaczono test chi-kwadrat (chi2), a gdy warunek Cochrana nie był spełniony test dokładny Fishera (Fisher dokładny) lub, w przypadku tabel 2x2 o rozmiarze próby większym niż 40, poprawkę Yatesa (chi2-Yates). Dla skali porządkowej wyznaczono test chi-kwadrat dla trendu. Jeśli nie oznaczono skali dla analizowanych zmiennych, przyjęto, że dane pochodzą ze skali nominalnej."
Zestawienie dla wielu grup niezależnych
Zestawienie Statystyka\(\to\)Zestawy\(\to\)Zestawienia testów [wiele grup niezależnych] porównuje jednocześnie dwie lub więcej grup wyznaczonych przez zmienną grupującą (np. kilka ośrodków, kilka schematów leczenia, kategorie wieku). Dla dwóch grup daje wyniki zgodne z zestawieniem dla dwóch grup niezależnych, jednak testami przeznaczonymi dla wielu grup (ANOVA zamiast testu t-Studenta itd.), dlatego przy dokładnie dwóch grupach wygodniej jest korzystać z zestawienia dla dwóch grup.
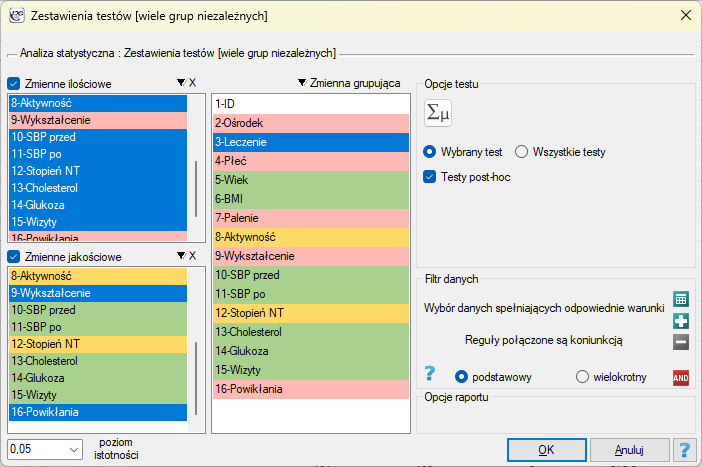
W oknie zestawienia wskazujemy zmienną grupującą oraz – tak jak w pozostałych zestawieniach – zmienne ilościowe i jakościowe, a następnie wybieramy:
- Wybrany test albo Wszystkie testy – w drugim przypadku dla zmiennych ilościowych raport zawiera kolumny z wynikiem testu normalności w grupach, testów Levene'a i Browna-Forsythe'a, ANOVA, ANOVA Welcha, ANOVA \(F^*\) Browna-Forsythe'a, ANOVA Kruskala-Wallisa, testu Conovera równości wariancji rang oraz miary wielkości efektu \(\eta^2\) i \(\epsilon^2\); dla zmiennych jakościowych – wyniki testu chi-kwadrat i dokładnego Fishera dla tabel \(r\times c\) oraz, dla skali porządkowej, ANOVA Kruskala-Wallisa dla kodów kategorii;
- Testy post-hoc – po zaznaczeniu tej opcji dla zmiennych, dla których test główny okazał się istotny, a grup jest co najmniej trzy, wykonywane są porównania wielokrotne: test Tukeya HSD po ANOVA, test T2 Tamhane po ANOVA Welcha, test Dunna z korektą Benjaminiego-Hochberga po ANOVA Kruskala-Wallisa, a dla zmiennych jakościowych porównania par grup testem chi-kwadrat lub dokładnym Fishera z korektą Benjaminiego-Hochberga. W kolumnie post-hoc raport wypisuje pary grup różniące się istotnie, a w kolumnach grup jednorodnych (GJ) grupy, które nie różnią się istotnie, otrzymują wspólną literę.
Miary opisowe dla każdej grupy zawierają domyślnie także liczność \(N\); podobnie jak w innych zestawieniach ich zakres ustawiamy w oknie statystyk opisowych.
Przykład 2. (plik zestawienia_wiele_grup.pqs)
Plik zawiera dane 1000 pacjentów z nadciśnieniem leczonych w czterech ośrodkach trzema schematami: Standard, Nowy lek i Placebo. Chcemy sprawdzić, czy schematy leczenia różnią się pod względem cech pacjentów i wyników leczenia. Porównania dokonujemy w oparciu o dane ilościowe: Wiek, BMI, SBP przed, SBP po (ciśnienie skurczowe przed leczeniem i po nim), Cholesterol, Glukoza i Wizyty (liczba wizyt), o cechy porządkowe: Aktywność i Stopień NT, oraz o dane nominalne: Płeć, Palenie i Powikłania. Skale zmiennych porządkowych i nominalnych są w pliku już ustawione.
W tym celu wybieramy menu Statystyka\(\to\)Zestawy\(\to\)Zestawienia testów [wiele grup niezależnych], jako zmienną grupującą wskazujemy Leczenie, w części dotyczącej zmiennych ilościowych wybieramy wymienione zmienne interwałowe, a w części dotyczącej zmiennych jakościowych – zmienne porządkowe i nominalne. Zaznaczamy opcje Wybrany test i Testy post-hoc i wykonujemy analizę.
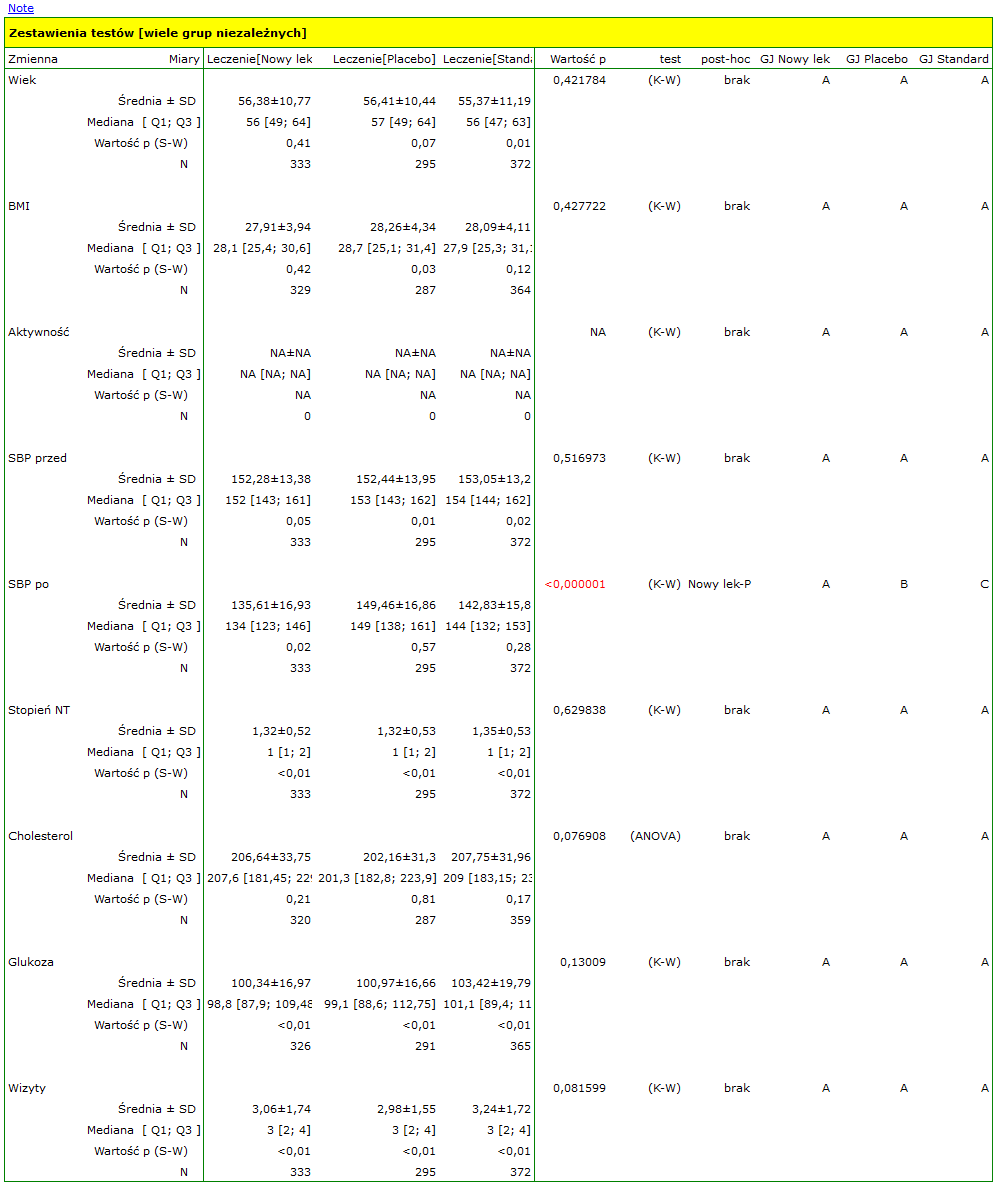
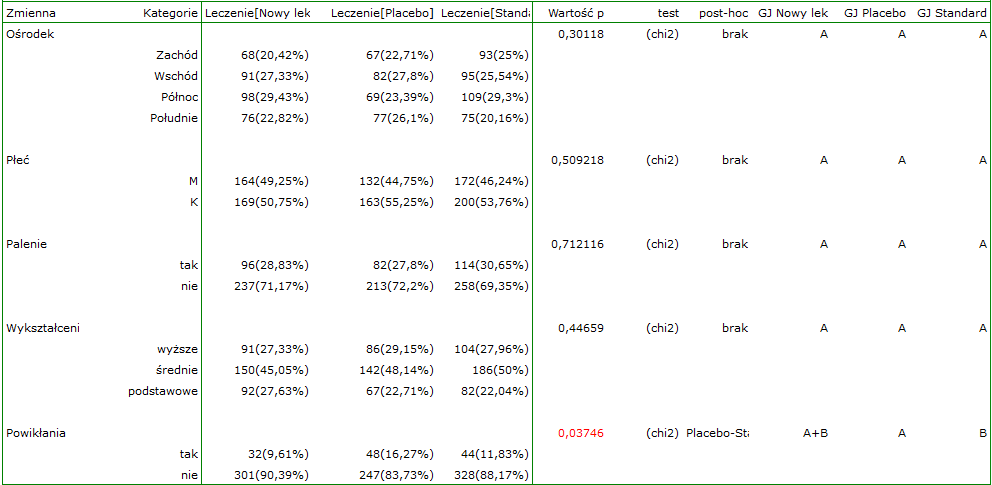
Ten sam plik pozwala wykonać zestawienie dla dwóch grup niezależnych (zmienna grupująca Płeć lub Palenie) oraz zestawienie dla wielu grup według ośrodka (Ośrodek, cztery grupy) lub stopnia nadciśnienia (Stopień NT, trzy grupy).
"Zmienne ilościowe:
Dla skali interwałowej z normalnością rozkładu we wszystkich grupach i równością wariancji wyznaczono jednoczynnikową ANOVA dla grup niezależnych (ANOVA), a gdy wariancje grup różniły się – ANOVA z korektą Welcha (Welch). Dla skali interwałowej, gdy warunek normalności rozkładu nie był spełniony, podobnie jak dla skali porządkowej wyznaczono ANOVA Kruskala-Wallisa (K-W). Normalność rozkładu badano testem Shapiro-Wilka, a równość wariancji testem Levene'a. Jeśli nie oznaczono skali dla analizowanych zmiennych, przyjęto, że dane pochodzą ze skali interwałowej.
Zmienne jakościowe:
Dla skali nominalnej wyznaczono test chi-kwadrat (chi2), a gdy warunek Cochrana nie był spełniony test dokładny Fishera (Fisher dokładny) lub, w przypadku tabel 2x2 o rozmiarze próby większym niż 40, poprawkę Yatesa (chi2-Yates). Dla skali porządkowej wyznaczono ANOVA Kruskala-Wallisa (K-W) dla kodów kategorii oraz test Conovera równości wariancji rang. Jeśli nie oznaczono skali dla analizowanych zmiennych, przyjęto, że dane pochodzą ze skali nominalnej.
Testy post-hoc:
Wyznaczono tylko dla co najmniej 3 grup i istotnego testu głównego: Tukey HSD (ANOVA), Tamhane T2 (Welch), Dunn z korektą Benjaminiego-Hochberga (K-W), porównania par grup testem chi-kwadrat lub dokładnym Fishera z korektą Benjaminiego-Hochberga (tabele RxC). W kolumnie post-hoc wypisano pary grup różniące się istotnie, a w kolumnach grup jednorodnych (GJ) grupy nieróżniące się istotnie mają wspólną literę."