 PQStat
Porównywanie modeli regresji PH Coxa z efektem losowym
Kiedy stosować:
Porównywanie modeli służy do wyboru zestawu zmiennych niezależnych, tak jak w porównywaniu modeli regresji PH Coxa: porównujemy model pełny z modelem zredukowanym lub korzystamy z doboru automatycznego. Efekt losowy (frailty gamma dla wskazanej zmiennej grupującej) jest wspólny dla wszystkich porównywanych modeli – w każdym z nich wariancja \(\theta\) jest szacowana na nowo, ale struktura grupowa pozostaje ta sama. Dobór dotyczy wyłącznie zmiennych niezależnych; o tym, czy efekt losowy jest potrzebny, decyduje test LR \(\theta=0\) w raporcie regresji Coxa z efektem losowym.
Definicje miar
Modele porównuje się na podstawie zintegrowanej log-wiarygodności, kryteriów informacyjnych AIC, AICc, BIC (im mniejsze, tym lepiej) oraz testu ilorazu wiarygodności dla modeli zagnieżdżonych: \(2(\ell_P-\ell_Z)\) (\(\ell_P\), \(\ell_Z\) – zintegrowana log-wiarygodność modelu pełnego i zredukowanego) ma rozkład \(\chi^2\) o liczbie stopni swobody równej liczbie usuniętych zmiennych.
Ocena modeli poza zbiorem uczącym
Kryteria informacyjne i test LR są wyznaczane na tych samych danych, na których dopasowano modele, przez co ocena modeli jest zbyt optymistyczna. Tak jak w porównywaniu modeli regresji PH Coxa, w oknie analizy można więc włączyć ocenę modeli na obserwacjach, które nie brały udziału w ich dopasowaniu (opcja Walidacja): walidację krzyżową \(k\)-krotną albo losowy zbiór testowy, z podziałem wyznaczonym przez Ziarno. Dla każdego modelu raport podaje wtedy \(-2\ln PL\) na zdarzenie (błąd walidacji; im mniejszy, tym lepiej) i współczynnik zgodności C Harrella, a w bloku doboru modelu – błąd modelu zerowego (bez zmiennych) i najlepszy model wg walidacji; jako kryterium doboru automatycznego można też wybrać błąd walidacji. W modelach z efektem losowym obowiązują dwie dodatkowe zasady:
- dzielone są całe grupy – wszystkie obserwacje jednej grupy (np. jednego pacjenta) trafiają do tej samej części danych. Liczba podziałów \(k\) jest ograniczana do liczby grup, a udział zbioru testowego oznacza procent grup (podział nie jest tu warstwowany względem statusu);
- przewidywanie dla nowej grupy opiera się wyłącznie na efektach stałych – efekt losowy grupy, której nie było w zbiorze uczącym, nie jest znany, dlatego przyjmuje się jego wartość oczekiwaną (frailty \(=1\)).
Jak ustawić analizę
Statystyka \(\to\) Modele mieszane \(\to\) Regresja PH Coxa z efektem losowym – porównywanie modeli.
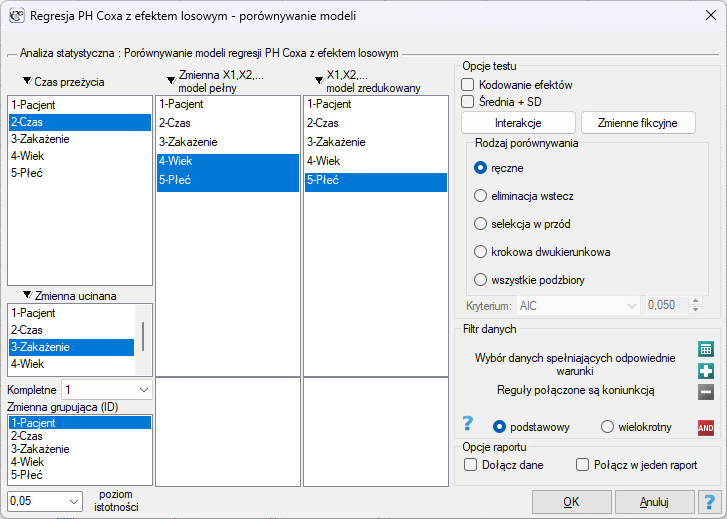
Wskazujemy czas przeżycia, zmienną ucinaną z wartością Kompletne, zmienne modelu pełnego i modelu zredukowanego (albo kryterium doboru automatycznego) oraz Zmienną grupującą (ID), wspólną dla wszystkich modeli. Pod listą metod doboru znajdują się pola: Kryterium (AIC, AICc, BIC, p (test LR / F) z progiem albo błąd walidacji), Walidacja (brak, krzyżowa, k = z liczbą podziałów albo zbiór testowy, % = z udziałem zbioru testowego w procentach grup) i Ziarno losowania podziału (to samo ziarno oznacza ten sam podział).
Wyniki i interpretacja
Raport zawiera tabelę dopasowania porównywanych modeli (zintegrowana log-wiarygodność, AIC, AICc, BIC, \(\theta\) każdego modelu) z testem LR między nimi oraz tabele współczynników modeli z warunkowymi hazard ratio. Przy włączonej walidacji raport zawiera dodatkowo blok Ocena poza zbiorem uczącym (sposób podziału, ziarno, jednostka podziału, błąd modelu zerowego, najlepszy model wg walidacji), a przy każdym modelu – \(-2\ln PL\) na zdarzenie i C Harrella.
Przykład 1. c.d. przykładu 1 (plik nerkiCewnik.pqs)
W modelu ryzyka zakażenia cewnika wiek okazał się nieistotny. Porównujemy model pełny (wiek i płeć) z modelem zredukowanym (sama płeć); efekt losowy pacjenta w obu.
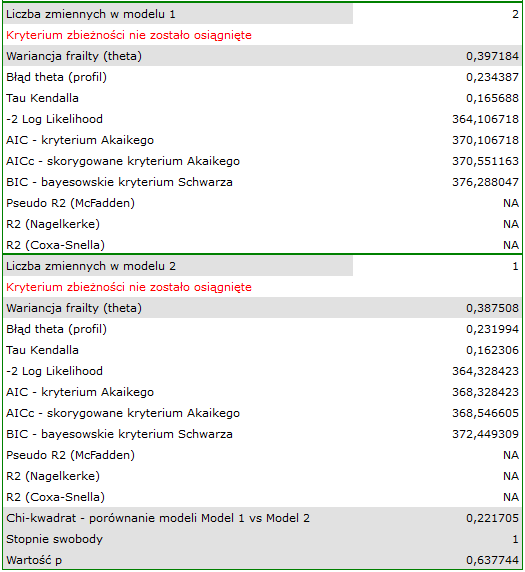
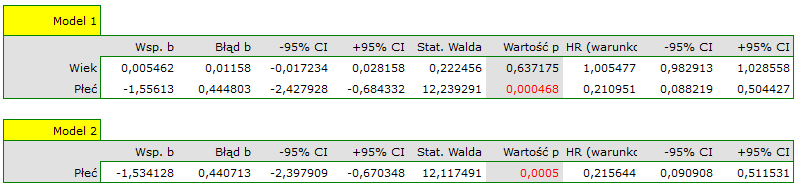
Model pełny: log-wiarygodność \(-182.05\), AIC \(=370.11\); model z samą płcią: \(-182.16\), AIC \(=368.33\). Test LR: \(\chi^2=0.22\), \(df=1\), \(p=0.64\) – usunięcie wieku nie pogarsza dopasowania, a AIC modelu prostszego jest niższe. Wybieramy model z samą płcią: \(HR=0.216\) (95% CI: 0.091–0.512), \(\theta=0.388\). Dla kontrastu model z samym wiekiem ma log-wiarygodność \(-187.86\) i AIC \(=379.72\), niewiele lepiej niż model bez zmiennych (\(-187.95\)): wiek sam nic nie wnosi.
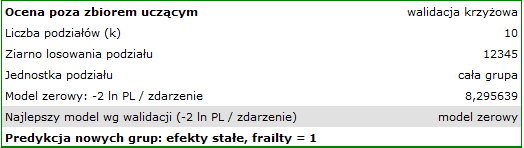
Ocena poza zbiorem uczącym. To samo porównanie powtarzamy, wybierając w polu Walidacja opcję krzyżowa, k = z 10 podziałami (ziarno 12345). Dzielonych jest 38 pacjentów – oba epizody tego samego pacjenta trafiają do tej samej części danych.
| zbiór uczący | walidacja krzyżowa (\(k=10\)) | ||
| model | AIC | \(-2\ln PL\) na zdarzenie | C Harrella |
| zerowy | 8.2956 | ||
| Model 1 (wiek, płeć) | 370.11 | 8.5322 | 0.6723 |
| Model 2 (płeć) | 368.33 | 8.4458 | 0.6186 |
Model z samą płcią ma mniejszy błąd walidacji niż model z wiekiem i płcią (8.4458 wobec 8.5322) – ocena poza zbiorem uczącym potwierdza, że wiek można usunąć. Jednocześnie najmniejszy błąd ma model zerowy (8.2956), choć płeć jest w modelu istotna, a C Harrella obu modeli (0.62–0.67) pokazuje, że porządkują one nowych pacjentów lepiej niż losowo. To sytuacja opisana w uwadze powyżej: efekt płci jest warunkowy (silny: \(HR=0.216\) przy \(\theta=0.388\)), próba mała (38 pacjentów, po 3–4 w każdej ocenianej części), a dla nowego pacjenta przyjmuje się frailty \(=1\), przez co przewidywania są zbyt skrajne. Wynik ten nie podważa znaczenia płci, ale przypomina, że przewidywania tego modelu dla nowych pacjentów – bez znajomości ich efektu losowego – są niepewne.