 PQStat
Porównywanie modeli regresji logistycznej mieszanej
Kiedy stosować:
Porównywanie modeli służy do wyboru zestawu zmiennych niezależnych (efektów stałych), tak jak w porównywaniu modeli regresji logistycznej: porównujemy model pełny z modelem zredukowanym lub korzystamy z doboru automatycznego (wsteczny, w przód, krokowy, podzbiory). Struktura losowa jest wspólna dla wszystkich porównywanych modeli: losowy wyraz wolny, losowe nachylenia i kowariancja ustawione w oknie obowiązują w każdym modelu, a zmienna z losowym nachyleniem pozostaje w każdym modelu jako efekt stały. Dobór dotyczy wyłącznie efektów stałych; o tym, czy losowe nachylenie jest potrzebne, decyduje test LR w raporcie regresji logistycznej mieszanej.
Definicje miar
Modele porównuje się kryteriami informacyjnymi AIC, AICc, BIC (im mniejsze, tym lepiej), pseudo-\(R^2\) oraz \(R^2\) brzegowym i warunkowym, a modele zagnieżdżone – testem ilorazu wiarygodności: \(2(\ell_P-\ell_Z)\) (\(\ell_P\), \(\ell_Z\) – logarytm wiarygodności modelu pełnego i zredukowanego) ma rozkład \(\chi^2\) o liczbie stopni swobody równej liczbie usuniętych zmiennych. Wiarygodność jest zawsze aproksymowana tą samą metodą (Laplace lub kwadratura) we wszystkich modelach, więc jest porównywalna.
Ocena modeli poza zbiorem uczącym
Kryteria informacyjne i test LR są wyznaczane na tych samych danych, na których dopasowano modele, przez co ocena modeli jest zbyt optymistyczna. Tak jak w porównywaniu modeli regresji logistycznej, w oknie analizy można więc włączyć ocenę modeli na obserwacjach, które nie brały udziału w ich dopasowaniu (opcja Walidacja): walidację krzyżową \(k\)-krotną albo losowy zbiór testowy, z podziałem wyznaczonym przez Ziarno. Dla każdego modelu raport podaje wtedy średnią dewiancję (\(-2\ln L/n\); to ona jest błędem walidacji), \(AUC\) i wskaźnik Briera, a w bloku doboru modelu – błąd modelu zerowego i najlepszy model wg walidacji; jako kryterium doboru automatycznego można też wybrać błąd walidacji. W modelach mieszanych obowiązują dwie dodatkowe zasady:
- dzielone są całe grupy – wszystkie obserwacje jednej grupy (np. jednego oddziału) trafiają do tej samej części danych. Obserwacje tej samej grupy są ze sobą skorelowane, więc rozdzielenie ich między część uczącą i ocenianą zaniżałoby błąd. Liczba podziałów \(k\) jest ograniczana do liczby grup, a udział zbioru testowego oznacza procent grup (podział nie jest tu warstwowany względem zmiennej zależnej);
- przewidywanie dla nowej grupy opiera się wyłącznie na efektach stałych – efekt losowy grupy, której nie było w zbiorze uczącym, nie jest znany, dlatego przyjmuje się jego wartość oczekiwaną, czyli zero. Miary walidacji mówią więc, jak dobrze efekty stałe modelu przewidują zdarzenie w nowej grupie (np. na nowym oddziale).
Modelem zerowym jest tu model z wyrazem wolnym, wspólną strukturą losową i zmiennymi, którym nadano losowe nachylenie (pozostają one w każdym modelu); jest on dopasowywany i oceniany tak samo jak pozostałe modele.
Jak ustawić analizę
Statystyka \(\to\) Modele mieszane \(\to\) Regresja logistyczna mieszana – porównywanie modeli.
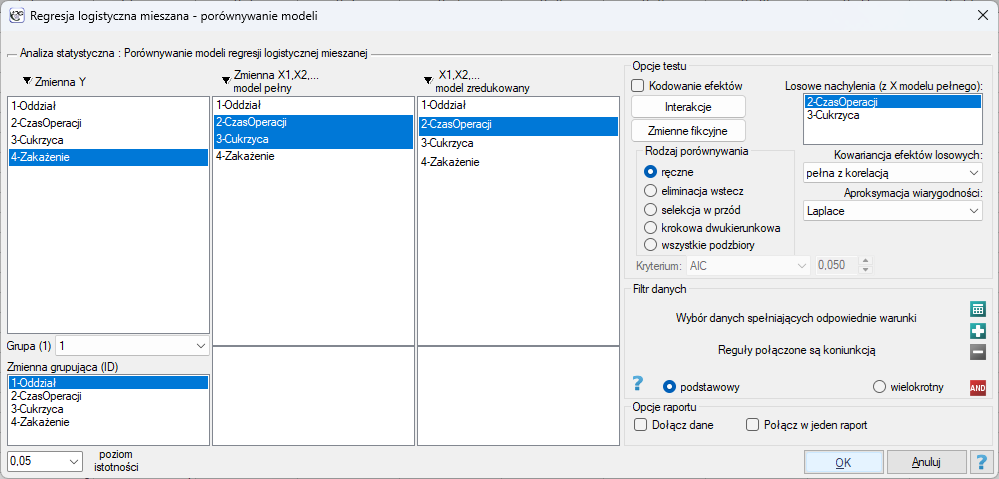
Wskazujemy zmienną zależną \(Y\) z wartością zdarzenia (Grupa (1)), zmienne modelu pełnego i zredukowanego (lub kryterium doboru) oraz opcje modelu mieszanego: Zmienna grupująca (ID), Losowe nachylenia (z X modelu pełnego), Kowariancja efektów losowych i Aproksymacja wiarygodności – wszystkie wspólne dla porównywanych modeli. Pod listą metod doboru znajdują się pola: Kryterium (AIC, AICc, BIC, p (test LR / F) z progiem albo błąd walidacji), Walidacja (brak, krzyżowa, k = z liczbą podziałów albo zbiór testowy, % = z udziałem zbioru testowego w procentach grup) i Ziarno losowania podziału (to samo ziarno oznacza ten sam podział).
Wyniki i interpretacja
Raport zawiera ramkę z opisem wspólnej struktury losowej, tabelę Kryteria informacyjne i testy LR z \(-2LL\), AIC, AICc, BIC, \(R^2\) brzegowym i warunkowym każdego modelu i testem LR między kolejnymi modelami oraz tabele współczynników modeli z warunkowymi ilorazami szans i wariancją efektów losowych każdego modelu. Przy włączonej walidacji raport zawiera dodatkowo blok Ocena poza zbiorem uczącym (sposób podziału, ziarno, jednostka podziału, błąd modelu zerowego, najlepszy model wg walidacji), a przy każdym modelu – średnią dewiancję, \(AUC\) i wskaźnik Briera.
Przykład 1. (plik oddziałyZakażenia.pqs)
Dane symulowane: w 40 oddziałach chirurgicznych obserwowano po 25 pacjentów po operacji. Dla każdego pacjenta zapisano, czy wystąpiło zakażenie miejsca operowanego (Zakażenie: 1 – tak), standaryzowany czas trwania operacji (CzasOperacji: 0 oznacza czas przeciętny, 1 – o jedno odchylenie standardowe dłuższy) oraz obecność cukrzycy (Cukrzyca: 1 – tak). Łącznie 1000 pacjentów, 404 zakażenia. Pacjenci tego samego oddziału dzielą personel, procedury i warunki sali, więc oddział jest zmienną grupującą. Ponieważ wpływ czasu operacji może zależeć od oddziału (na jednych oddziałach długie operacje są rutyną, na innych sygnałem powikłań), czas operacji dostaje losowe nachylenie. Pytamy, czy cukrzyca wnosi coś ponad czas operacji.
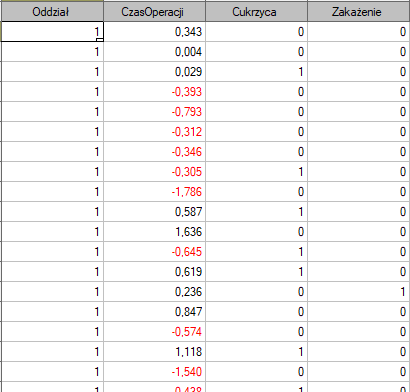
Ustawiamy Zakażenie jako \(Y\) z wartością 1 w polu Grupa (1), Oddział jako zmienną grupującą, model pełny: CzasOperacji i Cukrzyca, model zredukowany: sam CzasOperacji. Na liście Losowe nachylenia (z X modelu pełnego) zaznaczamy CzasOperacji (zmienna ta pozostanie w obu modelach), kowariancja pełna z korelacją, aproksymacja Laplace.
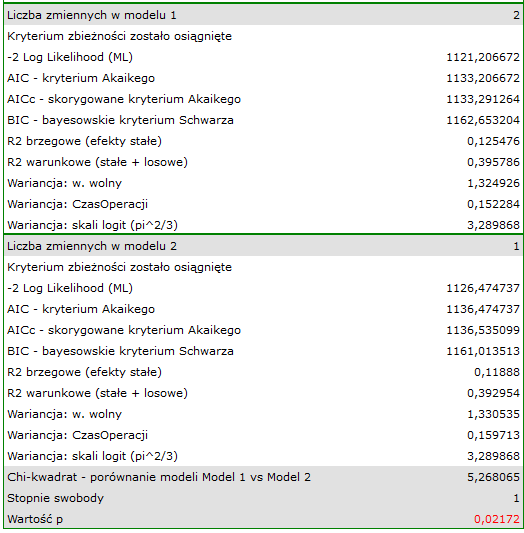
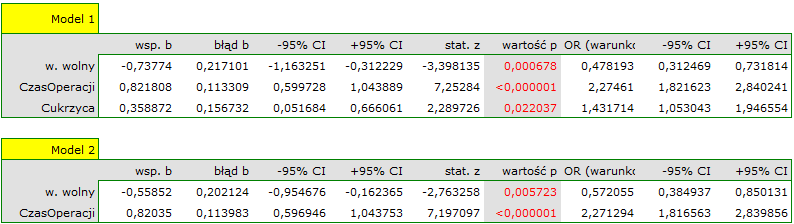
Model pełny ma \(-2LL=1121.21\), AIC \(=1133.21\), BIC \(=1162.65\); model zredukowany \(-2LL=1126.47\), AIC \(=1136.47\), BIC \(=1161.01\). Test LR: \(\chi^2=1126.47-1121.21=5.27\), \(df=1\), \(p=0.022\) – usunięcie cukrzycy istotnie pogarsza dopasowanie, AIC wskazuje model pełny, a BIC (surowiej karzący za parametry) – model zredukowany, ale różnica jest niewielka (1.6). W tabeli współczynników modelu pełnego cukrzyca ma warunkowy \(OR=1.43\) (95% CI: 1.05–1.95, \(p=0.022\)): u pacjentów tego samego oddziału, przy tym samym czasie operacji, cukrzyca zwiększa szanse zakażenia o 43%. Czas operacji: \(OR=2.27\) (1.82–2.84) na jedno odchylenie standardowe. Zostajemy przy modelu pełnym – wynik testu LR jest zgodny z testem Walda, a efekt cukrzycy ma sens kliniczny.
Struktura losowa. Oba modele mają wariancję losowego wyrazu wolnego około 1.33 (odchylenie 1.15 na skali logitowej – oddziały bardzo różnią się bazowym ryzykiem) i wariancję losowego nachylenia około 0.15 (odchylenie 0.39: efekt czasu operacji waha się między oddziałami od około \(0.82-0.78=0.04\) do \(0.82+0.78=1.60\) na skali logitowej). Test LR nachylenia w raporcie regresji logistycznej mieszanej daje \(p=0.095\), więc dowód na różne nachylenia jest słaby; model z samym losowym wyrazem wolnym ma AIC \(=1133.11\), praktycznie równe modelowi z nachyleniem. Wersja z kowariancją niezależne (korelacja i tak wynosi \(-0.06\)) ma najniższe AIC \(=1131.24\) i byłaby najoszczędniejszym wyborem.
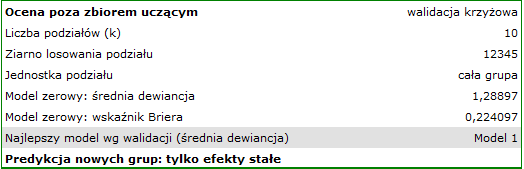
Ocena poza zbiorem uczącym. Sprawdzimy jeszcze, czy cukrzyca poprawia przewidywanie zakażeń na oddziałach, które nie brały udziału w dopasowaniu modelu. To samo porównanie powtarzamy, wybierając w polu Walidacja opcję krzyżowa, k = z 10 podziałami (ziarno 12345). Dzielonych jest 40 oddziałów – w każdym z 10 kroków modele są dopasowywane na 36 oddziałach, a oceniane na 4 pozostałych.
| zbiór uczący | walidacja krzyżowa (\(k=10\)) | |||
| model | AIC | śr. dewiancja | AUC | Brier |
| Model 1 (czas operacji, cukrzyca) | 1133.21 | 1.2843 | 0.6677 | 0.2227 |
| Model 2 (czas operacji) | 1136.47 | 1.2890 | 0.6657 | 0.2241 |
Czas operacji ma losowe nachylenie, więc pozostaje w każdym modelu – model zerowy jest tu tym samym modelem co Model 2 i stąd jednakowe wartości w raporcie. Model z cukrzycą ma mniejszą średnią dewiancję (1.2843 wobec 1.2890), nieco większe \(AUC\) (0.6677 wobec 0.6657) i mniejszy wskaźnik Briera (0.2227 wobec 0.2241), jest więc wskazany jako najlepszy według walidacji. Poprawa jest jednak niewielka: cukrzyca jest czynnikiem istotnym statystycznie, ale przewidywanie zakażeń na nowym oddziale poprawia w skromnym stopniu – o ryzyku decyduje przede wszystkim czas operacji i sam oddział, którego efektu losowego dla nowego oddziału nie znamy.