 PQStat
Porównywanie modeli regresji wielorakiej mieszanej
Kiedy stosować:
Porównywanie modeli służy do wyboru takiego zestawu zmiennych niezależnych (efektów stałych), który opisuje dane najlepiej przy możliwie małej liczbie parametrów. Działa tak samo jak porównywanie modeli regresji wielorakiej: porównujemy model pełny z modelem zredukowanym (bez części zmiennych) albo pozwalamy programowi wybrać model automatycznie (dobór wsteczny, w przód, krokowy lub przegląd podzbiorów).
W modelach mieszanych obowiązuje jedna dodatkowa zasada: struktura losowa jest wspólna dla wszystkich porównywanych modeli. Dobór dotyczy wyłącznie efektów stałych, a losowy wyraz wolny, losowe nachylenia i typ kowariancji ustalone w oknie pozostają w każdym z modeli. Zmienna, której nadano losowe nachylenie, pozostaje w każdym porównywanym modelu jako efekt stały (nie można usunąć efektu stałego zmiennej, zachowując jej losowe nachylenie). O tym, czy same efekty losowe są potrzebne, decydują testy LR w raporcie regresji wielorakiej mieszanej.
Definicje miar
Modele porównuje się na podstawie kryteriów informacyjnych AIC, AICc i BIC (im mniejsza wartość, tym lepszy model) oraz testu ilorazu wiarygodności (LR) dla modeli zagnieżdżonych: statystyka \(2(\ell_P-\ell_Z)\) (\(\ell_P\), \(\ell_Z\) – logarytm wiarygodności modelu pełnego i zredukowanego) ma rozkład \(\chi^2\) o liczbie stopni swobody równej liczbie usuniętych zmiennych. Nieistotny wynik oznacza, że usunięte zmienne nie wnoszą informacji i należy wybrać model prostszy; wynik istotny – że model pełny jest istotnie lepszy.
Ocena modeli poza zbiorem uczącym
Kryteria informacyjne i test LR są wyznaczane na tych samych danych, na których dopasowano modele, przez co ocena modeli jest zbyt optymistyczna. Tak jak w porównywaniu modeli regresji wielorakiej, w oknie analizy można więc włączyć ocenę modeli na obserwacjach, które nie brały udziału w ich dopasowaniu (opcja Walidacja): walidację krzyżową \(k\)-krotną albo losowy zbiór testowy, z podziałem wyznaczonym przez Ziarno. Dla każdego modelu raport podaje wtedy RMSE, MAE i \(R^2\) predykcji, a w bloku doboru modelu – błąd modelu zerowego i najlepszy model wg walidacji (o najmniejszym RMSE); jako kryterium doboru automatycznego można też wybrać błąd walidacji. W modelach mieszanych obowiązują dwie dodatkowe zasady:
- dzielone są całe grupy – wszystkie obserwacje jednej grupy (np. jednego pacjenta) trafiają do tej samej części danych. Obserwacje tej samej grupy są ze sobą skorelowane, więc rozdzielenie ich między część uczącą i ocenianą zaniżałoby błąd. Liczba podziałów \(k\) jest ograniczana do liczby grup, a udział zbioru testowego oznacza procent grup;
- przewidywanie dla nowej grupy opiera się wyłącznie na efektach stałych – efekt losowy grupy, której nie było w zbiorze uczącym, nie jest znany, dlatego przyjmuje się jego wartość oczekiwaną, czyli zero. Miary walidacji mówią więc, jak dobrze efekty stałe modelu przewidują obserwacje nowej grupy (np. nowego pacjenta), i odpowiadają \(R^2\) brzegowemu, a nie warunkowemu. RMSE obejmuje także zmienność między grupami, jest więc większe niż odchylenie standardowe reszt modelu.
Modelem zerowym jest tu model z wyrazem wolnym, wspólną strukturą losową i zmiennymi, którym nadano losowe nachylenie (pozostają one w każdym modelu); jest on dopasowywany i oceniany tak samo jak pozostałe modele.
Jak ustawić analizę
Statystyka \(\to\) Modele mieszane \(\to\) Regresja wieloraka mieszana – porównywanie modeli.
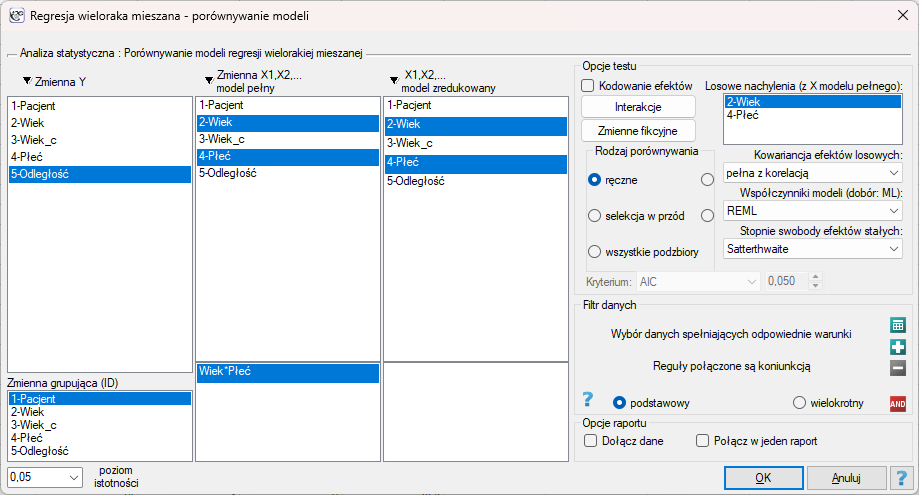
W oknie wskazujemy zmienną zależną \(Y\), zmienne modelu pełnego i zmienne modelu zredukowanego (lub kryterium doboru automatycznego), tak jak w porównywaniu modeli regresji wielorakiej. Opcje modelu mieszanego:
- Zmienna grupująca (ID) – kolumna identyfikująca grupę; wspólna dla wszystkich modeli,
- Losowe nachylenia (z X modelu pełnego) – zmienne, których efekt różni się między grupami; taka zmienna pozostaje w każdym porównywanym modelu,
- Kowariancja efektów losowych – niezależne lub pełna z korelacją, wspólna dla wszystkich modeli,
- Współczynniki modeli (dobór: ML) – REML lub ML dla tabel współczynników; sam dobór zawsze ML,
- Stopnie swobody efektów stałych – Satterthwaite lub test z Walda w tabelach współczynników,
- Kryterium – kryterium doboru automatycznego: AIC, AICc, BIC, p (test LR / F) z progiem albo błąd walidacji,
- Walidacja – brak, krzyżowa, k = z liczbą podziałów (od 2 do 100, domyślnie 10) albo zbiór testowy, % = z udziałem zbioru testowego w procentach grup (od 5 do 90, domyślnie 30); dzielone są całe grupy,
- Ziarno – ziarno losowania podziału (domyślnie 12345); to samo ziarno oznacza ten sam podział.
Wyniki i interpretacja
Raport zawiera ramkę z opisem wspólnej struktury losowej (zmienna grupująca, liczba grup, składniki losowe, kowariancja), tabelę Kryteria informacyjne i testy LR z wartościami \(-2LL\) (ML), AIC, AICc, BIC, \(R^2\) brzegowym i warunkowym każdego modelu oraz testem LR między kolejnymi modelami, a także tabele współczynników porównywanych modeli (efekty stałe warunkowe, z wariancjami efektów losowych każdego modelu). Jeśli dla któregoś modelu wystąpiło dopasowanie osobliwe, jest to zaznaczone w tabeli. Przy włączonej walidacji raport zawiera dodatkowo blok Ocena poza zbiorem uczącym (sposób podziału, ziarno, jednostka podziału, błąd modelu zerowego, najlepszy model wg walidacji), a przy każdym modelu – RMSE, MAE i \(R^2\) predykcji.
Przykład 1. c.d. przykładu 2 (plik ortodoncja.pqs)
W modelu wzrostu odległości przysadka–szczelina skrzydłowo-szczękowa znalazły się: wiek, płeć i interakcja wiek\(\times\)płeć. Sprawdzimy, czy interakcja (różne tempo wzrostu dziewczynek i chłopców) jest rzeczywiście potrzebna, porównując model pełny z modelem zredukowanym bez interakcji. Struktura losowa: losowy wyraz wolny i losowe nachylenie wieku, kowariancja pełna, wspólne dla obu modeli.
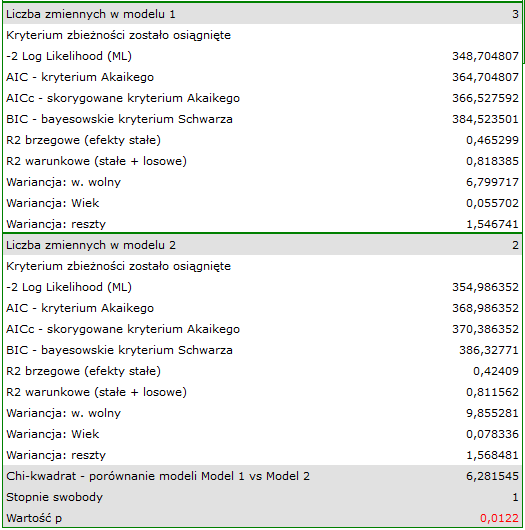
Model pełny ma \(-2LL=348.70\) (ML), AIC \(=364.70\), BIC \(=384.52\); model bez interakcji \(-2LL=354.99\), AIC \(=368.99\), BIC \(=386.33\). Test LR: \(\chi^2=354.99-348.70=6.28\), \(df=1\), \(p=0.012\) – usunięcie interakcji istotnie pogarsza dopasowanie, a oba kryteria informacyjne wskazują model pełny. Zostajemy przy modelu z interakcją: dziewczynki i chłopcy rosną w różnym tempie. Gdybyśmy dodatkowo porównali model z samym wiekiem (\(-2LL=360.72\), AIC \(=372.72\)), okazałoby się, że płeć wnosi informację tylko razem z interakcją – w modelu bez interakcji jej efekt to średnia różnica w całym zakresie wieku (\(b=-2.04\), \(p=0.008\)), która ukrywa fakt, że różnica ta rośnie z wiekiem.
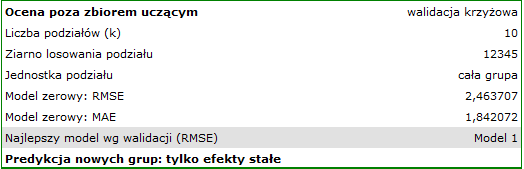
Ocena poza zbiorem uczącym. Sprawdzimy jeszcze, czy interakcja poprawia przewidywanie wzrostu u dzieci, które nie brały udziału w dopasowaniu modelu. To samo porównanie powtarzamy, wybierając w polu Walidacja opcję krzyżowa, k = z 10 podziałami (ziarno 12345). Dzielonych jest 27 pacjentów, a nie 88 pomiarów – wszystkie pomiary jednego dziecka trafiają do tej samej części.
| zbiór uczący | walidacja krzyżowa (\(k=10\)) | |||
| model | AIC | RMSE | MAE | \(R^2\) predykcji |
| zerowy (sam wiek) | 2.46 | 1.84 | ||
| Model 1 (z interakcją) | 364.70 | 2.27 | 1.80 | 0.41 |
| Model 2 (bez interakcji) | 368.99 | 2.31 | 1.80 | 0.38 |
Model z interakcją ma mniejszy błąd poza zbiorem uczącym (RMSE \(=2.27\) mm wobec \(2.31\) mm) i większe \(R^2\) predykcji (\(0.41\) wobec \(0.38\)); oba modele przewidują lepiej niż model zerowy, który – ze względu na losowe nachylenie wieku – zawiera sam wiek (RMSE \(=2.46\) mm). Walidacja potwierdza więc wynik testu LR i kryteriów informacyjnych, choć przewaga modelu z interakcją jest niewielka. Warto zauważyć, że \(R^2\) predykcji (\(0.41\)) jest zbliżone do \(R^2\) brzegowego modelu (\(0.47\)), a nie do warunkowego (\(0.82\)): dla nowego dziecka nie znamy jego efektu losowego, więc przewidywanie opiera się na samych efektach stałych.